
 無料会員登録
「個人情報を使ってデータ分析したいけど、プライバシーが心配」「GDPRや個人情報保護法に対応しながらデータを活用したい」「PETsって何のこと?」——データ活用とプライバシー保護を両立する技術として注目されているのが「PETs(Privacy Enhancing Technologies)」です。
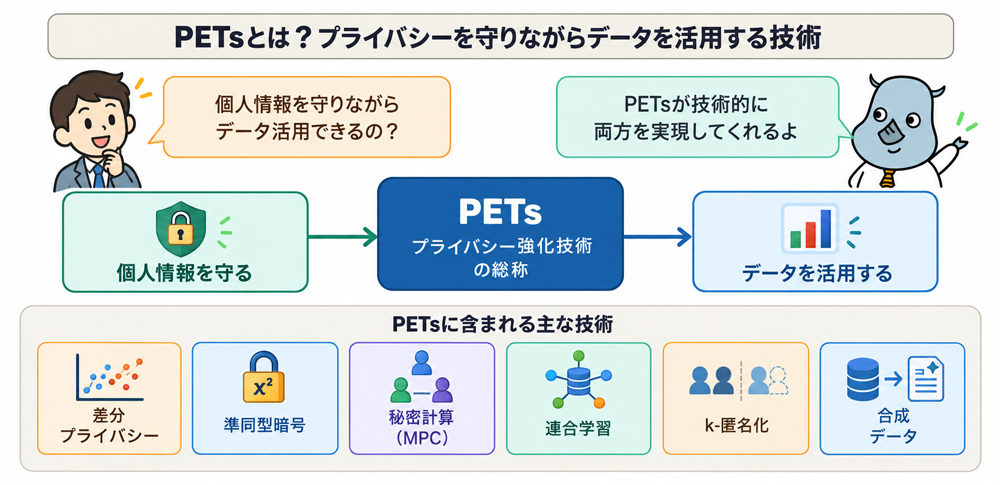
PETs(Privacy Enhancing Technologies:プライバシー強化技術)とは、個人情報やプライバシーを守りながらデータを分析・活用できるようにする技術の総称です。「個人情報は守りたい、でもデータは活用したい」というジレンマを解決する技術群として、医療・金融・マーケティング・行政など多くの分野で注目されています。
従来は「個人情報を使う=プライバシーリスクがある」という状況でしたが、PETsを使うことで「個人を特定しにくい形でデータを分析する」「データを暗号化したまま計算する」といったことが可能になります。
PETsとは?
PETs(Privacy Enhancing Technologies)は「プライバシーを強化する技術」という意味で、個人情報を守りながらデータを分析・活用するための技術をまとめた言葉です。
PETsが注目される背景
- データ活用への需要増加:AI・機械学習の普及でデータ分析の価値が高まっている
- プライバシー規制の強化:GDPR(EU)・個人情報保護法(日本)など世界的にプライバシー保護規制が厳しくなっている
- データ漏洩リスクの高まり:サイバー攻撃が増加して個人情報漏洩の被害が拡大している
- 信頼の重要性:利用者からのデータ提供への信頼を得るためにプライバシー保護への取り組みが必要
PETsの代表的な技術
PETsにはいくつかの技術が含まれます。それぞれをかんたんに説明します。
差分プライバシー(Differential Privacy)
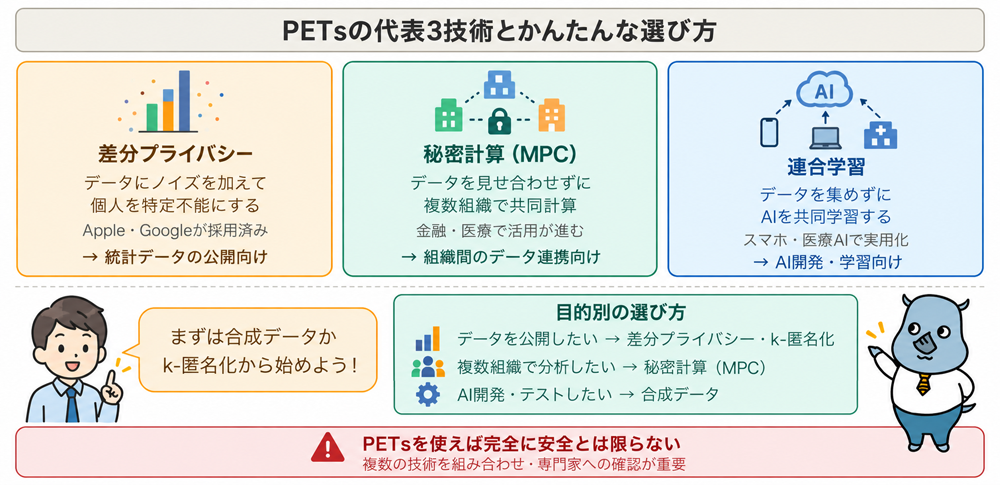
差分プライバシーとは、データに意図的にノイズ(ランダムなズレ)を加えることで、個人の情報を推測しにくくしながら、全体の傾向を分析できるようにする技術です。
「先月、違法なことをしましたか?」というアンケートを正直に答えてもらうのは難しいです。そこで「コインを投げて表なら本当のことを答え、裏なら『はい』と答えてください」というルールにします。集計側はコインの確率を知っているので「本当の割合」を計算できますが、個々の回答が本当の答えかランダムな答えかはわかりません。差分プライバシーはこの考え方を数学的に厳密にしたものです。
- 使われている場面:スマートフォンの利用傾向の収集・ブラウザ利用データの分析・統計データの公開など
- メリット:個人を特定するリスクを数学的に抑えながら、全体傾向を分析しやすい
- デメリット:ノイズを加えるため分析結果の精度が下がることがある
準同型暗号(Homomorphic Encryption)
準同型暗号とは、データを暗号化したまま計算できる暗号技術です。通常は暗号化されたデータを計算するには一度復号(暗号を解く)が必要ですが、準同型暗号では暗号化したまま計算して、結果だけを復号できます。
銀行員に自分の給与明細を見せずに「私の税金を計算してください」と頼みたいとします。準同型暗号は「箱の中に給与明細を入れて鍵をかけたまま、箱に穴を通して計算できる特殊な箱」のようなものです。計算結果だけが出てきて、銀行員は中の給与明細を見ることはできません。
- 使われている場面:医療データの分析・金融機関間でのデータ活用・クラウド上でのプライバシー保護計算など
- メリット:データを他者に見せずに計算処理を依頼できる
- デメリット:通常の計算に比べて処理が重くなりやすく、用途や計算内容によっては実用化に工夫が必要
秘密計算・秘密分散(MPC:Multi-Party Computation)
秘密計算(MPC:マルチパーティコンピュテーション)とは、複数の組織がそれぞれのデータを互いに見せ合うことなく、共同で計算・分析できる技術です。
3社の企業がそれぞれの売上データを持っています。「3社の売上の平均を知りたいけど、自社のデータは他社に見せたくない」という状況です。MPCを使うと、各社がデータを暗号化した状態で計算に参加して、最終的な平均値だけが全員に共有されます。誰も他社の個別データを見ることはできません。
- 使われている場面:銀行間での不正検知・医療機関間でのデータ分析・広告効果測定など
- メリット:複数の組織が協力してデータ分析できる・各組織のデータは守られる
- デメリット:計算処理が複雑・ネットワーク通信が多くなる
連合学習(Federated Learning)
連合学習とは、データをひとつの場所に集めることなく、各端末・各組織でAI(機械学習)モデルを学習させて、学習結果(モデルの重み)だけを共有する技術です。
複数の学校が「生徒の成績データを使って良い教え方を見つけたい」と考えています。連合学習では各学校が自分の生徒データで学習して「こういう教え方が効果的だった」という学習結果だけを共有します。個々の生徒の成績データは各学校の外に出ません。
- 使われている場面:スマートフォンの入力補助・医療AIの開発・金融機関の不正検知AIの協調学習など
- メリット:個人データを一か所に集める必要がない・データの分散管理ができる
- デメリット:モデルの「重み」や学習結果から一定の情報が推測される可能性がある
k-匿名化・l-多様性(Anonymization)
k-匿名化とは、データセットの中で同じ特徴(年齢・居住地・性別等)を持つ人が必ず「k人以上」になるようにデータを加工して、個人を特定しにくくする技術です。
「40代・男性・東京都千代田区在住」というデータが1件だけあると個人が特定されるかもしれません。k=3の匿名化では「同じ条件の人が最低3人以上いる」ように、住所を「東京都」にまとめたりデータを丸めたりします。犯人が人混みに紛れるように、個人をグループの中に紛れ込ませます。
- 使われている場面:医療統計データの公開・行政データの公開・研究用データセットの提供
- メリット:実装が比較的シンプル・古くから使われており実績がある
- デメリット:複数のデータを組み合わせると個人が特定される「再識別リスク」がある
合成データ(Synthetic Data)
合成データとは、実在の個人データをそのまま使わずに、統計的な特性を再現した「架空のデータ」を生成する技術です。
医師の卵が「本物の患者の診療記録」で練習するとプライバシー問題が起きます。そこで「本物の患者と似た統計的特性を持つ架空の患者データ」を作って練習に使います。データの傾向を保ちながら、実在の患者データをそのまま使わない形で活用できるようにします。
- 使われている場面:AIモデルのテスト・開発環境でのデータ利用・機械学習の学習データ不足の補完
- メリット:プライバシーリスクを低減できる・データ量を増やしやすい
- デメリット:本物のデータと全く同じ特性にはならない・生成モデルの品質によって精度が変わる
書籍「セキュリティ対策の基礎知識」
メルマガ登録でプレゼント!
セキュリティ対策で何をして良いかわからない
企業の情シス部門の方必見!
PETsの種類まとめ
| 技術名 | 一言説明 | 主な用途 | 難易度・コスト |
|---|---|---|---|
| 差分プライバシー | ノイズを加えて個人を特定しにくくする | 統計データの公開・収集 | 中程度 |
| 準同型暗号 | 暗号化したまま計算できる | クラウド上での秘密計算 | 高い(処理が重い) |
| 秘密計算(MPC) | 複数組織がデータを見せ合わずに共同計算 | 複数組織間のデータ協力 | 高い |
| 連合学習 | データを集めずにAIを学習させる | スマホ・医療AI・金融AI | 中〜高 |
| k-匿名化 | 同じ特徴の人をk人以上のグループにする | 統計データの公開 | 比較的低い |
| 合成データ | 本物の傾向に近い架空データを生成 | AI開発・テスト | 中程度 |
GDPRや個人情報保護法との関係
PETsはプライバシー保護規制への対応手段としても注目されています。
GDPRとPETs
EU一般データ保護規則(GDPR)は「データ保護・バイ・デザインおよびデータ保護・バイ・デフォルト」の考え方を求めています。PETsはこの考え方を技術的に支える手段のひとつとして検討されます。
個人情報保護法(日本)とPETs
日本の個人情報保護法では「仮名加工情報」「匿名加工情報」という概念が設けられています。k-匿名化や差分プライバシーなどの技術は、匿名加工情報や統計データの作成において再識別リスクを下げる手段として検討されることがあります。
PETsを使えば必ずしも「個人情報ではなくなる」とは限りません。使用する技術・パラメーター(設定値)・データの性質・照合可能性・提供方法などによって判断が異なります。規制対応としてPETsを活用する場合は、法律の専門家への確認が必要です。
企業でのPETs活用事例
医療分野:患者データを外に出さずにAI開発
複数の病院が患者の診療データを使って病気の早期発見AIを共同開発したい場合、患者の個人情報を他の病院や開発会社に渡すことは簡単ではありません。連合学習を使うことで各病院のデータを外に出さずにAIを共同学習できる可能性があります。医療分野では、プライバシーを守りながらデータを活用する方法として、こうした技術の活用が検討されています。
金融分野:銀行間で不正を検知する
A銀行で口座を開いた人がB銀行でも口座を開いて不正行為をしようとしている場合、A銀行とB銀行がデータを共有できれば早期検知できます。しかし顧客データの共有はプライバシー問題になります。秘密計算(MPC)を使うことでお互いのデータを見せ合わずに「この人は不正リストに載っているか」を確認できる可能性があります。
広告・マーケティング分野:広告効果を測定する
広告主は「自社サイトへの訪問者」のデータを持ち・広告媒体(SNS等)は「広告を見た人」のデータを持っています。「広告を見た人が実際に購入したか」を測定するには双方のデータを突き合わせる必要がありますが、顧客データを直接共有するのはプライバシー問題です。秘密計算やプライバシー保護を前提とした計測技術を使って、お互いの個人データを見せずに広告効果を計測する取り組みが進んでいます。
どのPETsを選べばいいか
PETsにはさまざまな技術があり「どれを使えばいいかわからない」という方向けに、目的別の選び方を整理します。
- 統計データを公開・提供したい:差分プライバシーまたはk-匿名化が適しています。差分プライバシーは数学的な保証を設計しやすく、k-匿名化は実装が比較的シンプルです
- 複数の組織でデータを共有せずに分析したい:秘密計算(MPC)または連合学習が適しています。データを一か所に集めずに共同計算できます
- クラウドに暗号化したままデータを預けて処理したい:準同型暗号が選択肢になります。ただし現状では処理が重くなりやすいため、用途を限定して使うのが現実的です
- AI開発・テスト環境のデータ問題を解決したい:合成データが選択肢になります。本番データをそのまま使わずにAI開発・テストを進められる可能性があります
PETsに関連する注意事例2選
事例①:匿名情報のつもりが個人情報を送信していたケース
個人情報を外部に提供する際、「匿名化したつもり」でも、実際には個人を特定できる情報が残っている場合があります。名前を削除していても、他の項目との組み合わせや元データとの照合によって、個人が識別できてしまう可能性があるためです。
サイバーセキュリティ.comでは、東京しごと財団が支援利用者56名の情報を匿名加工して企業488社へ送信しようとしたところ、実際には個人が特定できる状態の情報を送信していた事例が報じられています。
このような事例は、「氏名を削除した」「一部の項目を伏せた」だけでは十分な匿名化とは限らないことを示しています。PETsを活用する際も、k-匿名化、差分プライバシー、統計処理などを目的に応じて検討し、再識別リスクを評価することが重要です。

事例②:生成AIに個人情報を入力し、漏えい可能性が生じたケース
AIやデータ分析を活用する際、実データをそのまま外部サービスに入力してしまうと、個人情報や機密情報の漏えいリスクが生じます。特に、生成AIや外部の分析ツールに顧客情報・職員情報・医療情報などを入力する場合は、利用規約、保存期間、学習利用の有無、アクセス権限などを確認する必要があります。
サイバーセキュリティ.comでは、業務委託先の担当者が個人情報を生成AIサービスへ入力し、漏えいの可能性が生じた事例が報じられています。
このような事例は、データ活用の前に「どのデータをそのまま使ってよいのか」「匿名化・仮名化・合成データ化できないか」「外部サービスに入力してよい情報か」を確認する重要性を示しています。PETsは、AI活用やデータ分析におけるプライバシーリスクを下げるための選択肢になります。
よくある質問(FAQ)
Q. PETsを使えば個人情報保護法に準拠できますか?
PETsはプライバシー保護の技術的手段として有効ですが、使えば必ず準拠できるというわけではありません。どの技術をどのパラメーターで使うか・データの性質・用途によって判断が変わります。日本の個人情報保護法における「匿名加工情報」の要件を満たすかどうかは、使用するPETsの種類・設定値・データの特性によって異なるため、法律の専門家への確認を推奨します。
Q. 中小企業でもPETsを使えますか?
技術によります。合成データの生成ツールやk-匿名化のツールは比較的手軽に導入できるものが増えています。一方で準同型暗号・秘密計算(MPC)は専門知識と計算リソースが必要で、現時点では大企業・研究機関が中心です。まず「合成データの活用」や「差分プライバシー対応のツール」から始めるのが現実的です。
Q. 連合学習と差分プライバシーは組み合わせて使えますか?
はい。「差分プライバシー付き連合学習(DP-FL)」として組み合わせて使われることがあります。連合学習の弱点である勾配攻撃などのリスクを、差分プライバシーのノイズ付加で軽減する考え方です。
Q. 合成データは本物のデータと同じように使えますか?
統計的な傾向は近いですが、完全に同じではありません。特に「まれな事象・極端な値」の再現が難しい場合があります。AIモデルの開発・テスト・プロトタイプ作成には有効ですが、本番モデルの最終学習には本物のデータが必要な場合もあります。「プライバシーリスクを下げながらデータを活用する補完的な手段」として位置づけるのが適切です。
Q. PETsはGDPRの「忘れられる権利」に対応できますか?
技術によります。連合学習では端末や組織にデータが分散しているため、特定の個人のデータを削除する「アンラーニング(機械学習モデルから特定のデータの影響を除去する)」が課題になる場合があります。差分プライバシーや匿名化された統計データを使う場合でも、GDPRへの対応はPETsの種類、実装方法、データの状態、法的解釈によって変わるため、専門家への確認が必要です。
まとめ
PETs(Privacy Enhancing Technologies:プライバシー強化技術)とは、個人情報を守りながらデータを活用できるようにする技術の総称です。差分プライバシー(ノイズを加えて個人を特定しにくくする)・準同型暗号(暗号化したまま計算できる)・秘密計算MPC(複数組織がデータを見せ合わずに共同計算できる)・連合学習(データを集めずにAIを学習させる)・k-匿名化(同じ特徴の人をグループにして個人を隠す)・合成データ(統計的に近い架空データを生成する)などの技術が含まれます。
PETsはGDPRの「データ保護・バイ・デザイン」や、日本の個人情報保護法における匿名加工情報・仮名加工情報への対応を検討する際の技術的手段として活用できますが、使えば必ず準拠できるわけではなく法律の専門家への確認が必要です。
「PETsを使えば完全に安全」というわけではなく、連合学習の勾配攻撃のように新たな攻撃手法が研究で示されることもあります。目的に合った技術を選び、複数のPETsを組み合わせながらプライバシーリスクを管理することが重要です。
書籍「セキュリティ対策の基礎知識」
メルマガ登録でプレゼント!
セキュリティ対策で何をして良いかわからない
企業の情シス部門の方必見!
関連コラム(あわせて、以下の記事もよく読まれています)
【個人情報漏洩】中小企業が陥るAI活用の罠と鉄壁の防御策
【中小企業必見】生成AI利用時の個人情報保護ガイド
【中小企業のAI活用術】個人情報を守るセキュリティ対策
EU-US DPF
PGP
COBIT
ヒューリスティック
プライバシーシールド





病院が「当院の患者の平均年齢は52歳です」と発表しても、個々の患者が特定される可能性は低いでしょう。でも「この町で糖尿病を患っている47歳の男性」と公表したら特定されるかもしれません。PETsは「個人が特定されるリスクを下げながらデータを使う仕組みを技術的に支える」ものです。「気をつけて使う」だけではなく、技術的な工夫によってプライバシーリスクを低減するのがポイントです。